大模型把“写个分词器”这类基础活吞掉了,但自然语言处理算法应用工程师并没有退场,只是工作重心挪到了语义链路的工程一侧。
从“训模型”转向“管语义”
早几年 NLP 应用的日常是微调 BERT、对比句向量、维护词典。现在主流做法变成三层架构:
意图与槽位解析:判断用户一句话究竟要跳哪个业务分支;
检索增强链路:把私有知识切成块、打分、重排,再交给生成模块汇总;
评测护栏:针对幻觉、拒答、越权指令建固定测试集,而不是靠人肉聊天抽查。
为什么应用层比底座更缺人手
底座权重迭代快,半年就会换一代;但企业私域里的工单、合同、客服记录、操作规程不会自动变整齐。把非结构化文本接进审批流、风险规则和可审计日志,这件事高度依赖熟悉分词边界、指代消解和异常样本设计的工程师。
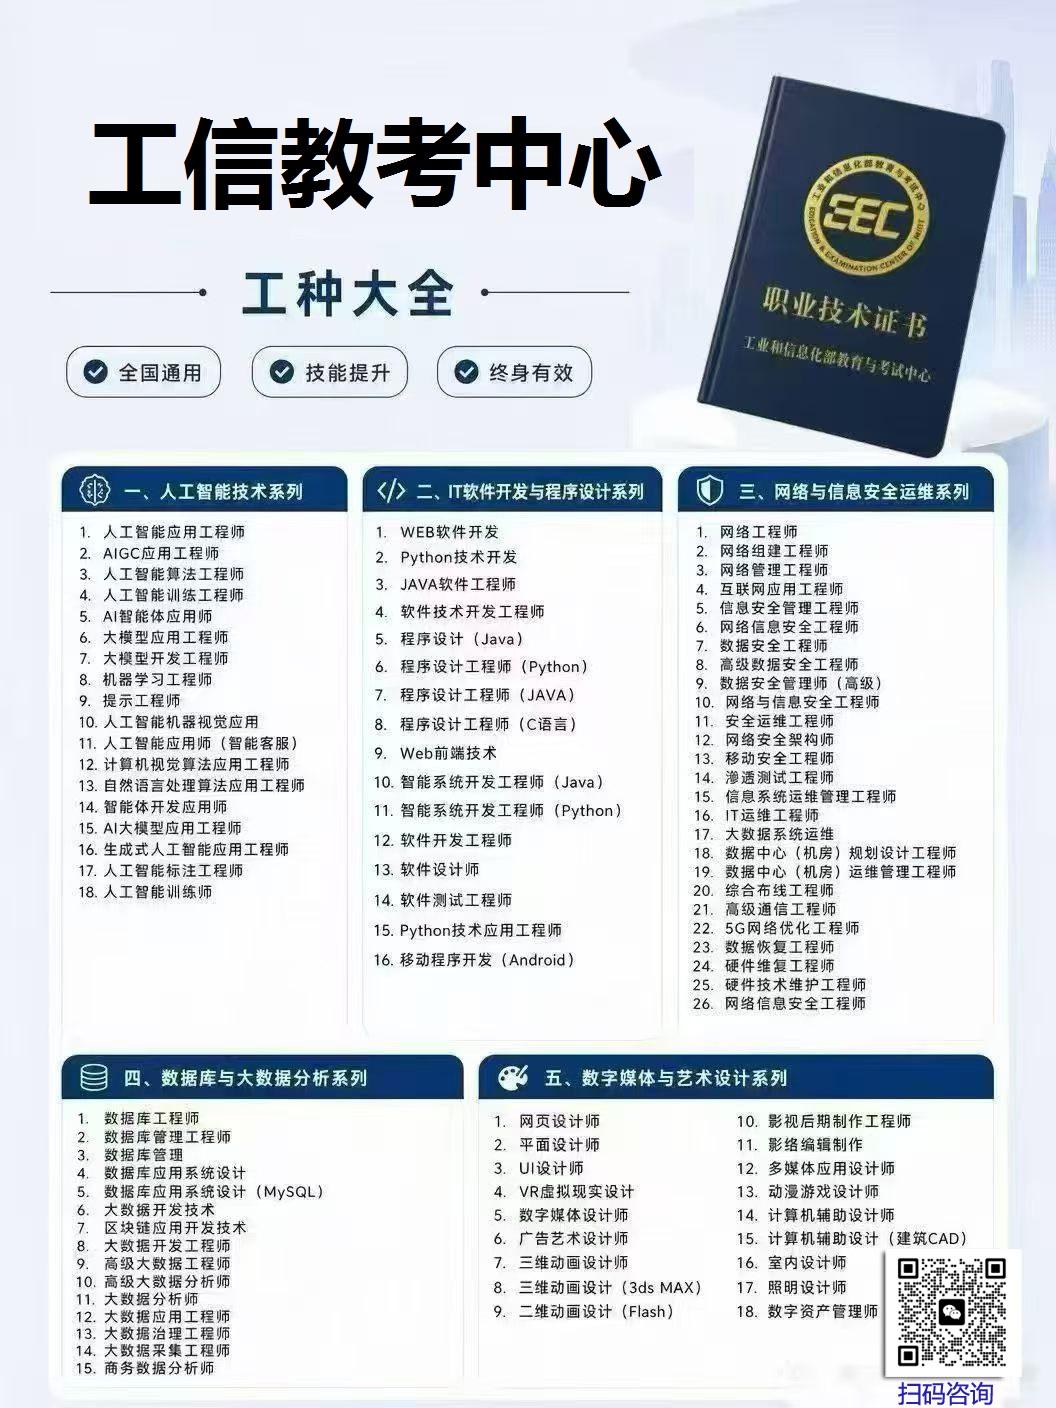
EEC工信教考中心,自然语言处理算法工程师,辉达
马老师13521730416
丁老师13522094648
一份不算卷的能力地图
文本侧:正则与有限状态机、span 抽取、去标识化;
检索侧:稠密召回 + 稀疏召回混合、重排序指标 nDCG;
评测侧:构建黄金集、按业务场景拆 bad case,而不是只看 BLEU/ROUGE;
工程侧:流式解码超时控制、敏感片段过滤、多轮会话状态压缩。
💡 一个判断方法:如果一段文本处理流程,出了错没法定位到具体 token,多半还没到可上线水平。